 辣椒AI - 知识助理
 辣椒科研 - 自动化研究助手
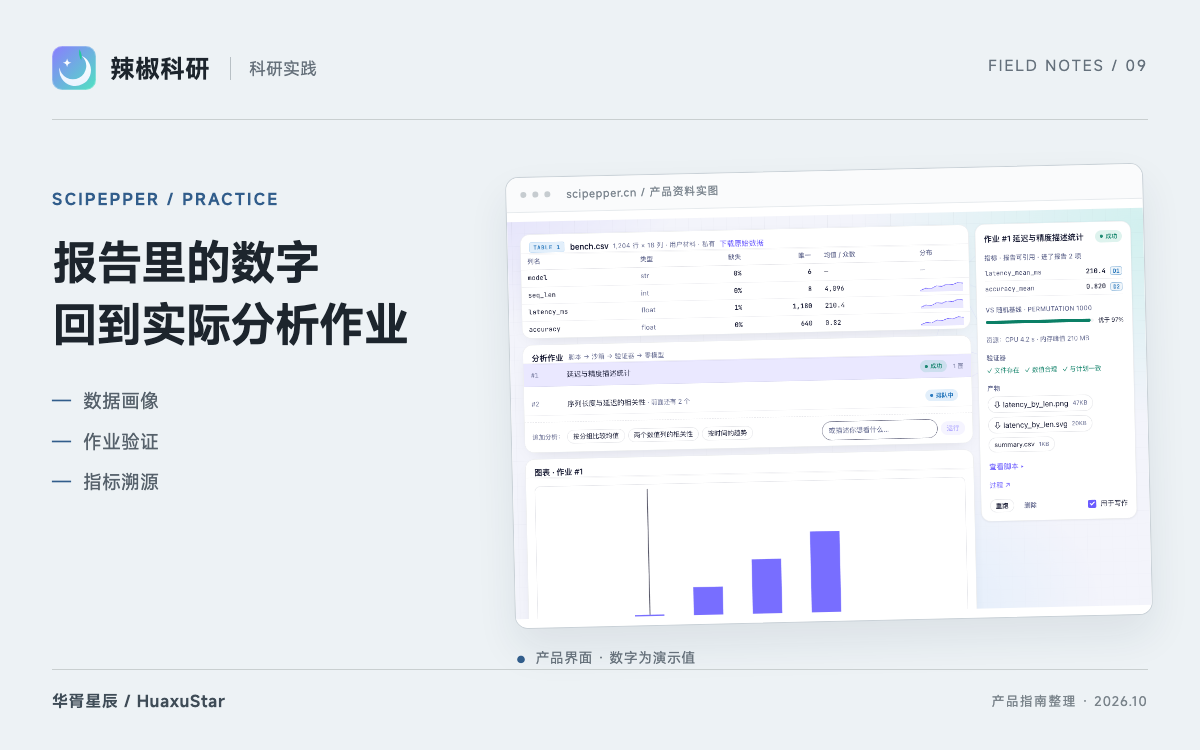
一张表能生成很多统计结果,但报告真正需要的是「针对哪个问题、在什么数据上、跑了什么作业、结果如何回查」。辣椒科研的数据分析把数据画像、分析作业和正文指标记号连接在一起,适合按这条证据链组织交付。
下面以自有 CSV 或 Excel 数据为输入说明操作,不给出未经运行的显著性、模型表现或业务改善结论。
一、先确认文件与研究问题
写清行代表什么、列的单位是什么、哪一列是结果变量、哪些是分组或解释变量。检查缺失值、重复记录、日期和异常编码,再上传当前版本。
CSV 与 Excel 会进入数据分析;PDF 和 Word 属于材料,不会因此自动变成可计算的数据表。当前指南说明,Excel 读取第一个工作表,追加分析与沙箱实验使用第一份表格,因此多表任务应先安排好上传顺序和工作表内容。
有个人信息提示时,在研究确认前决定脱敏方式。默认脱敏与保留原样不是同一种处理,不能在分析开始后再假设已经自动改变。
二、先看画像,再审阅分析计划
数据画像帮助检查列类型、缺失情况和分布。它用于理解输入,不应把画像里的每个数都当作已经通过分析验证的正文指标。
根据研究问题检查作业:描述统计是否足够、分组条件是否成立、回归变量是否确实存在、时间趋势是否使用了正确的时间列。若任务发生抽样,应保留抽样提示及范围。
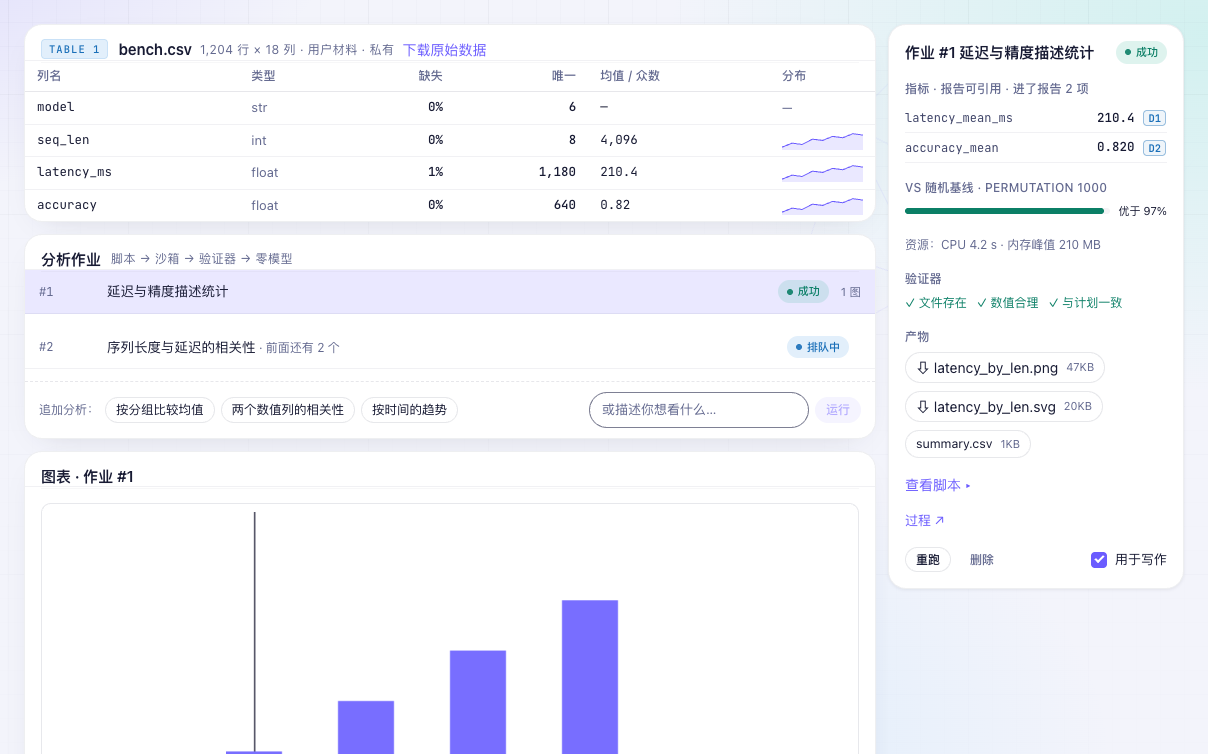
官方指南的 MSW 演示界面。行数、均值、准确率和随机基线比例均是演示固定值,不能用于证明某个模型或真实数据集的结果。
三、区分作业完成与结果可引用
作业有输出,不等于可以写进报告。指南中的验证包括文件是否产出、数值是否合理、结果与计划是否一致;验证未通过的指标会标为不可引用。
| 层次 | 需要留下的依据 |
|---|---|
| 输入 | 数据版本、列含义、清洗和抽样情况 |
| 计划 | 问题、变量、方法与分组方式 |
| 执行 | 脚本、状态、失败或重跑记录 |
| 指标 | 值、单位、D 编号与验证状态 |
| 解释 | 该结果能说明什么,不能说明什么 |
失败作业需要查看原因或重新运行,不用模型猜一组看起来正常的值补到报告里。
四、让正文数字回到 D 编号
通过验证的分析指标获得任务内的 D 编号。正文出现相应数字时,检查记号能否跳回数据页,值、单位、分组条件是否一致。
显著性、置信区间或基线比较有各自适用条件。即便程序顺利算出结果,也要检查样本、变量定义和统计假设;相关性不能单凭一个数升级为因果解释。
五、下载复现材料并完成验收
交付时保留报告、图表、分析脚本和指标文件。指南中的数据包提供脚本、指标、画像与环境说明,但不包含原始数据;要复现还需研究者自行保存有权限使用的原始文件。
最终检查以「能否沿着正文数字找到作业与输入条件」为主线。删除或重跑作业后,也要重新检查正文引用是否仍有效,不把旧报告里的数字无条件沿用到新分析。
产品入口与资料来源
打开辣椒科研。本文依据以下公开产品指南整理,核对日期为 2026 年 10 月 15 日;具体入口与可用选项以产品当前页面为准。
想在你的业务里试试同样的做法?
告诉我们业务问题与数据现状,我们会给出方案建议与落地路径。
需要帮助?
联系我们的团队,获取贴合你业务场景的方案建议。