 辣椒AI - 知识助理
 辣椒科研 - 自动化研究助手
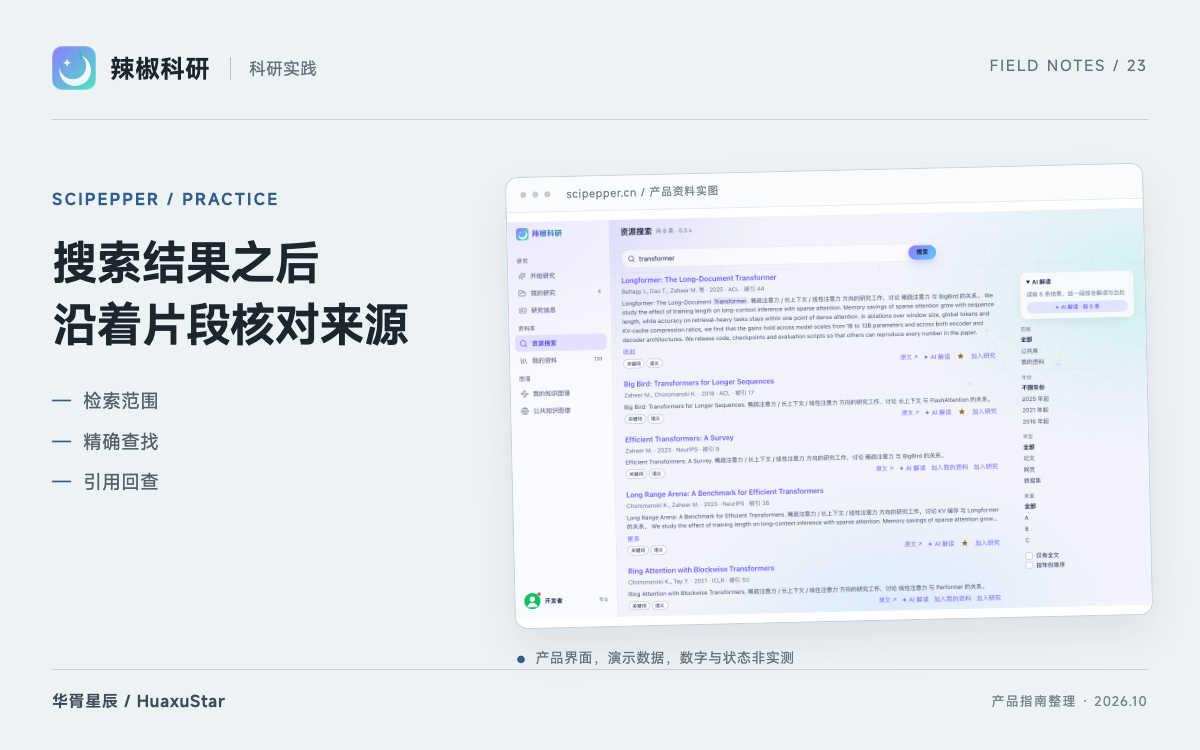
辣椒搜索(https://scipepper.cn/search )像 Google 学术:一个框,搜问题、主题、作者或 DOI。看懂它的排序与三个范围,能省掉很多「明明有这篇怎么没排在前面」的疑惑。
搜什么、在哪搜
输入 ≤ 300 字。范围三选一:全部(公共库 ∪ 我的资料)、公共库(已进公共知识库的条目)、我的资料(研究筛入 + 手动加入 + 收藏的条目)。「我的资料」范围按账号可见权限检索:别人私有文件的正文块在任何范围都不会出现,哪怕那条目也在你的资料里。
粘 DOI、arXiv 号或网址会显示「精确查找」徽标:命中的条目置顶,标注精确匹配;库里没有时提示「没有找到 … 对应的条目」并列出语义相近的结果,DOI 还给一个「按 DOI 抓取」按钮,直接拉元数据进我的资料。
没有输入词时是探索视图,按排序字段列范围内条目。
排序规则
一次搜索走三路召回:标题 / 摘要关键词、语义向量(bge-m3;摘要块与正文块分开)、图谱实体(命中实体 → 相邻条目,只在含公共库时跑)。指南说明结果按以下规则排序:
- 标题或摘要命中的整组排在只命中正文块的前面。关键词命中标题或摘要、或摘要语义相似度过线,都算「命中元数据」;结果卡的 命中说明中可查看标题、摘要或正文匹配。
- 组内分数 = 相关度 × 0.6 + 权威度 × 0.4。权威度 = 0.55 × 被引(对数,参照 3000 次记满分)+ 0.15 × 年均被引 + 0.15 × 质量档 + 0.15 × PageRank(相对本次候选最大值)。
- 「我的资料」范围不用权威度——你自己的库里按相关度排。
所以一篇高被引综述只要摘要沾边就会靠前,而一篇只在正文第 8 页提到检索词的论文会落到后半段。总数封顶 500 条,每页 20 条,触底自动加载。
某一路不可用不会报错,只在结果头部提示:向量服务不可达时显示「语义匹配稍后可用,先按关键词 / 图谱返回」;图库未启用时少掉图谱一路。
筛选
- 年份:不限 / 近 1 年 / 近 5 年 / 近 10 年(按起始年过滤)。
- 排序:默认相关度;勾「按年份排序」改成年份倒序(同年按 PageRank)。探索视图提供默认的排序结果。
- 类型(论文 / 预印本 / 网页 / 数据集 …)、质量(A / B / C 档)chips。
- 仅有全文:只要有全文文件的条目。
筛选条件写进网址,可以直接把带筛选的链接发给别人。最近搜过的 10 条存在浏览器本地。
结果卡上能做什么
- 标题 / 原文 ↗:新窗口打开原文(DOI → arXiv → 落地页 → PubMed 的顺序取可用链接)。
- 命中片段:≤ 300 字,命中词按偏移高亮(英文停用词、中文虚词不高亮);标着页码
p.n。「更多 / 收起」展开完整摘要。 - 阅读:可站内读的条目打开阅读器并定位到片段所在页、高亮那段;只有摘要的条目打开摘要视图 + 原文链接。哪些能站内读见 我的资料。
- ★ 收藏:「加入我的资料」,幂等;只能收公共层条目或本来就对你可见的。
- ⋯ 更多:「解读这篇」;「加入研究」把条目直接送进某项研究的文献表(不查外部源)。
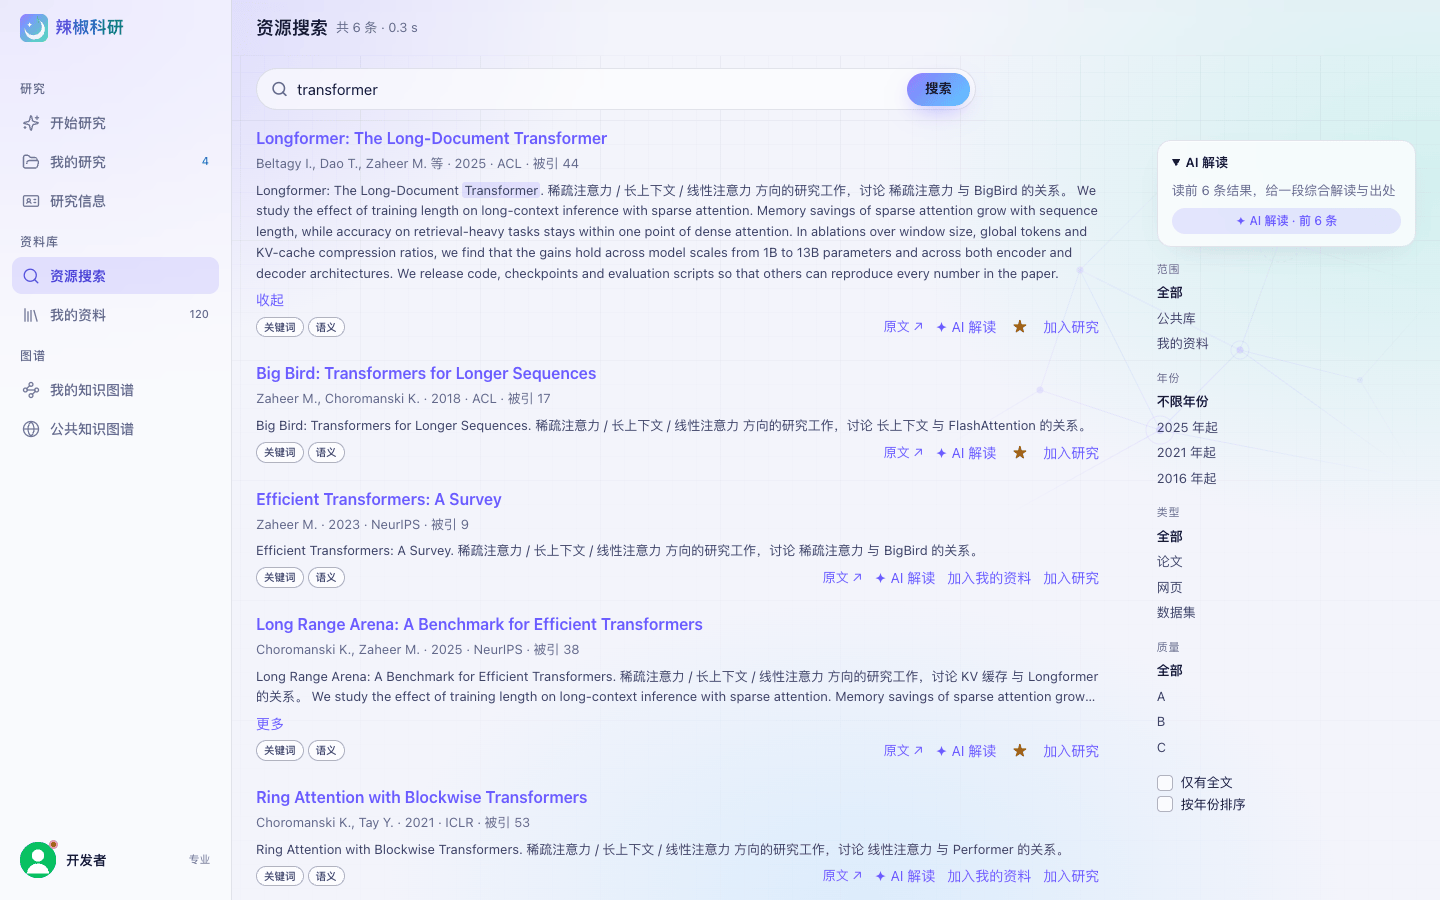
产品指南中的演示界面,数字与状态不代表真实任务结果。 结果卡底部的「关键词 / 语义」标记说明这条是怎么命中的;右侧筛选与「AI 解读」常驻,解读的是当前前几条。
AI 解读
两种入口:结果列表上方「AI 解读 · 前 N 条」(取前 8 条做综合解读),结果卡「解读这篇」(单篇)。解读是受限 RAG:只把选中条目的片段和元数据喂给模型,每个含事实 / 数字 / 结论的句子末尾必须标 [n],n 指向本次列出的片段;片段里没有的内容模型要明说「片段中未找到」。输出后代码逐个核 [n],越界的替换成 [?] 并计数提示;没有可依据的片段就不调模型。
- 单篇:固定四段(讲什么 / 方法与数据 / 主要发现 / 局限),你有进行中的研究课题时加第五段「与你的研究的关系」。
- 综合:≤ 400 字综合回答 + 「证据最强的 3 篇」+ 「观点分歧」+ 3 个可点的追问。
- 追问:延续同一会话,每轮再多召回 8 段。会话 7 天内可回放。
点解读里的 [n] 会跳到对应结果卡或打开阅读器定位那段。解读语言跟界面语言。
用量:AI 解读受账号额度约束,次数与可用状态以当前页面为准。
坑
- 「全部」范围下你的私有上传件也会出现在结果里,但只有你能看到它们的片段。
- 摘要缺失的来源(许可证不许存摘要)只有标题 + 片段块,关键词命中标题才排得上「元数据命中」组。
- 解读只依据片段,不是全文通读:单篇最多喂 40 段、综合每篇取最相似 3 段、总共 ≤ 30 段。想深读还是打开阅读器。
- 年份筛选只有起始年,没有区间;要按区间筛请去研究任务的确认页。
从搜索结果形成一份阅读清单
先记录课题问题和检索词,再查看结果为什么命中。标题相近但只在正文偶然出现关键词的条目,不能与方法和数据都相关的研究混为一谈。阅读摘要后记录纳入或排除的理由,把真正相关的条目加入自己的资料,再进入原文检查方法、样本和局限。
AI 解读适合辅助挑选下一篇阅读材料,不能替代全文核对。遇到片段缺失或引用无法对应时,保留这一缺口,不把模型补充的解释直接写成来源结论。
产品入口与资料来源
打开辣椒科研。本文依据公开产品指南移植整理,整理日期为 2026 年 10 月 15 日。
想在你的业务里试试同样的做法?
告诉我们业务问题与数据现状,我们会给出方案建议与落地路径。
需要帮助?
联系我们的团队,获取贴合你业务场景的方案建议。