 辣椒AI - 知识助理
 辣椒科研 - 自动化研究助手

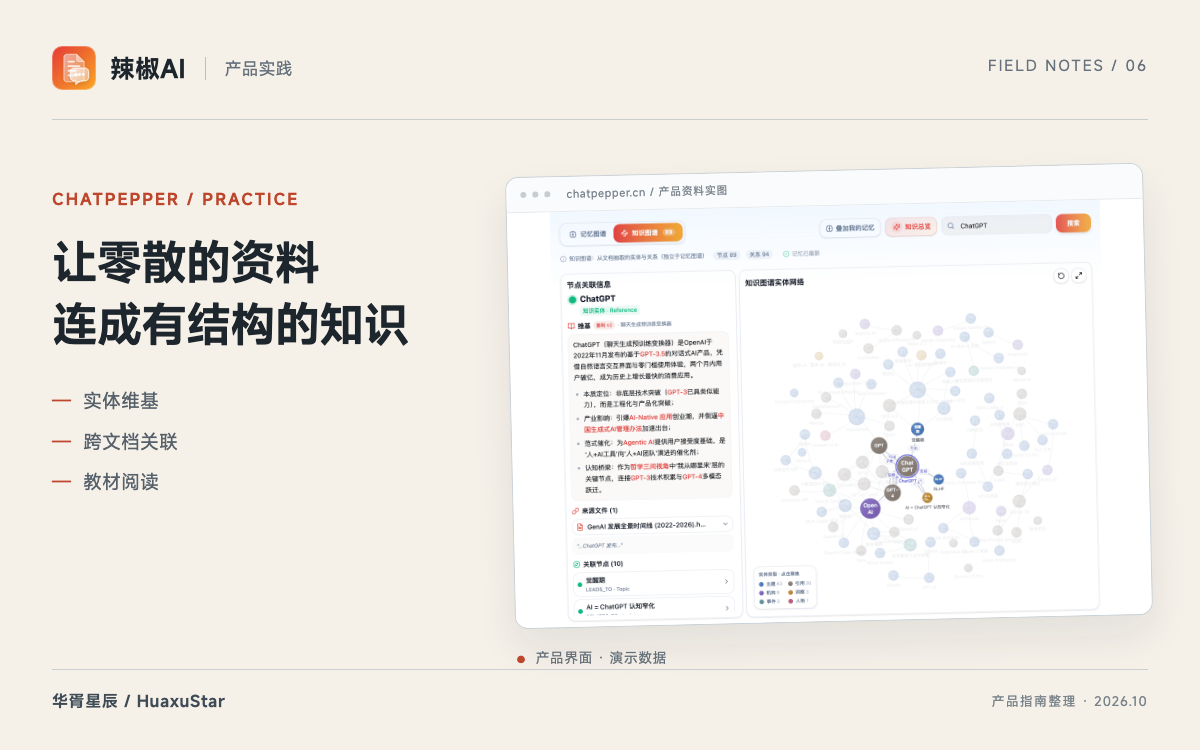
写在前面 这是 辣椒AI 里我们自己最满意的一个设计。它解决的问题很具体:当用户上传了几百份资料后,怎么让系统真的"记住"了什么,而不是攒下一堆检索得到、但串不起来的碎片。
一、常规做法为什么不好用
做知识图谱的标准流程是:拿到文档全文 → 抽取实体和关系 → 建图。
在学术文献或企业文档上跑一遍,你会得到这样的结果:
- 一篇论文抽出几百个节点,绝大多数是专业名词
- 节点之间的关系稀疏且随机,图看起来密密麻麻但没有结构
- 同一个概念在不同文档里被抽成不同的节点,图越来越碎
- 用户看到这张图,第一反应是"很酷",第二反应是"然后呢"
根本问题在于:全文抽取抽的是"文档里提到了什么",而用户想知道的是"这份资料对我意味着什么"。 这是两件事。
一个对比实验
我们做了一个简单的对比:同一篇万字论文,用两种方式建图。
方式 A(全文抽取):抽出 247 个实体节点、312 条关系边。其中 80% 的节点是论文中提到的技术名词(算法名、数据集名、评价指标名)。图很大,但密集集中在论文核心主题周围,外围几乎全是孤立的"提及"关系。
方式 B(摘要抽取):抽出 23 个实体节点、35 条关系边。节点包括论文的核心洞察、提出的问题、作者建议的后续方向。图小很多,但每个节点都有明确的认知含义。
方式 B 的图直接就能回答"这篇论文讲了什么、我得出了什么结论、接下来要研究什么"——这正是用户需要从第二大脑里得到的。方式 A 的图能回答"这篇论文提到了哪些概念"——这在学术检索场景有用,但在个人记忆场景是噪声。

二、换一个漏斗
我们把流程改成了四步:
原始文件 → Markdown 正文 → 提炼摘要(Summary) → 抽取记忆实体
关键差别在第三步。抽实体的输入不是全文,而是摘要。
摘要是模型对这份材料的理解结果——它已经过滤掉了细节,留下的是核心结论、关键观点和值得记住的东西。从摘要里抽出来的实体,天然就是"重要的"。
这一步让节点数量降了一个量级,而且降下来的都是噪声。
"先理解"的三个好处
- 噪声自限。全文有几十处提到"深度学习",但摘要里可能只在核心论点处提到一次——这就足够了。目的不是穷举概念,而是表达认知。
- 关系密度更高。摘要是紧凑的叙述,实体之间的关系在摘要里已经天然关联。抽取出来不需要额外的"共现分析"来补关系。
- 天然去重。摘要把相似内容的多次出现浓缩成一次表达,避免了全文抽取中同一个概念被多次建立节点的问题。
三、认知型的实体分类
第二个关键决定是实体分类。我们没有用"人物/地点/组织"这类通用命名实体类型,而是按"这对用户的记忆意味着什么"来分:
| 类型 | 含义 |
|---|---|
Topic | 主题——这份材料在讲什么 |
Insight | 洞察——从中得到的结论或启发 |
Person | 人物 |
Organization | 机构 |
Event | 事件 |
Action | 行动项——看完这份材料后应该做什么 |
Question | 问题——材料引出的、尚未解决的疑问 |
Reference | 引用——它提到的其他资料 |
Insight、Action、Question 这三类是通用命名实体识别里不存在的,但恰恰是它们让这张图变成了"记忆"而不是"索引"。
一个用户读完十篇材料后,图里会沉淀出他关心的主题、得出的判断、想做的事、以及还没想明白的问题。这些东西串起来,才是"第二大脑"该有的样子。
为什么 Insight 是最重要的实体类型
在八类实体中,Insight 是权重最高的。因为:
- 它是用户自己认知的凝练——不是原文说了什么,而是用户读了之后想到了什么
- 它与其他实体的关系最丰富——一个 Insight 可能关联一个 Topic(得出这个洞察的上下文)、关联另一个 Insight(支持或矛盾)、关联一个 Action(基于这个洞察该做什么)
- 它是后续决策的输入——当用户需要做一个判断时,图谱中相关的 Insight 能提供支撑
四、关系类型
关系同样是围绕认知设计的:
RELATES_TO(相关)、LEADS_TO(导向)、SUPPORTS(支持)、CONTRADICTS(矛盾)、MENTIONS(提及)、FOLLOWS_UP(后续跟进)、AUTHORED_BY(作者)、BELONGS_TO(归属)。
其中 CONTRADICTS 特别有用——当两份材料的结论相互矛盾时,这条边会把它们连起来。用户后来再看这个主题,能立刻发现"这里有分歧",而不是只记得最后读到的那个观点。
CONTRADICTS 关系在传统知识图谱中很少被显式标注,因为它需要"判断"而不是"匹配"。正是因为我们在摘要阶段要求模型主动识别矛盾点,才能在抽取时建立这条边。这是"先理解"思路的又一个具体体现。
五、工程链路
抽取是异步的,不能阻塞用户上传:
文件上传
  → 创建理解任务(状态 Pending)
  → 后台线程快速抽取 / 定时任务兜底认领
  → 基于 Markdown 提炼摘要
  → 回调写入主库
  → 后台拉起图谱抽取
  → 实体与关系写入关系库,拓扑同步至图数据库
两个设计点:
双轨兜底。 优先用后台线程快速处理,保证用户上传后很快能看到结果;同时有定时任务扫描 Pending 状态的任务作为兜底,避免线程异常导致任务永久卡住。
关系库 + 图数据库双写。 实体和关系的权威数据存在关系型数据库里(便于事务、权限和溯源),图数据库存拓扑(便于多跳查询和可视化)。两者职责不同,不是冗余。
同步策略的选择
为什么不只用图数据库?因为:
- 权限校验在图数据库中表达复杂,在关系库中是成熟能力
- 实体到原始资料的溯源关联在关系库中更自然
- 图数据库的备份恢复策略和业务数据库不同,把权威数据放在一起更利于运维
同步从关系库到图数据库是单向、异步的——关系库写完了再同步,不存在"回写"的需求。同步失败有重试和告警,但不会影响记忆图谱的权威记录。
六、溯源
每一个实体都记录它是从哪份资源、哪段摘要中抽出来的。
这一条看起来是小事,实际非常重要:当用户看到图里有一个"洞察"节点,他会问"我什么时候得出这个结论的"。没有溯源,这张图就是一堆无法验证的断言;有了溯源,它才是可信的记忆。
七、还没解决的问题
诚实地说,这套设计目前仍有几个待改进的地方:
- 跨资源的实体合并。同一个概念在不同材料里可能抽成两个节点,目前的合并策略还比较粗糙。我们正在尝试基于语义相似度的自动合并建议,但仍需人工确认。
- 时间维度。用户的观点会随时间变化,图目前对"我三个月前是这么认为的,现在改了"表达得还不够好。一个可能的方向是在 Insight 节点上引入版本链。
- 摘要质量决定一切。摘要提炼得不好,后面全白搭。这一环对模型能力的依赖比较重,是我们持续优化的重点。
我们仍在迭代。但"先理解、再记忆"这个方向,我们认为是对的——图谱的价值不在于节点多,而在于节点值得被记住。
想在你的业务里试试同样的做法?
告诉我们业务问题与数据现状,我们会给出方案建议与落地路径。

需要帮助?
联系我们的团队,获取贴合你业务场景的方案建议。