 辣椒AI - 知识助理
 辣椒科研 - 自动化研究助手
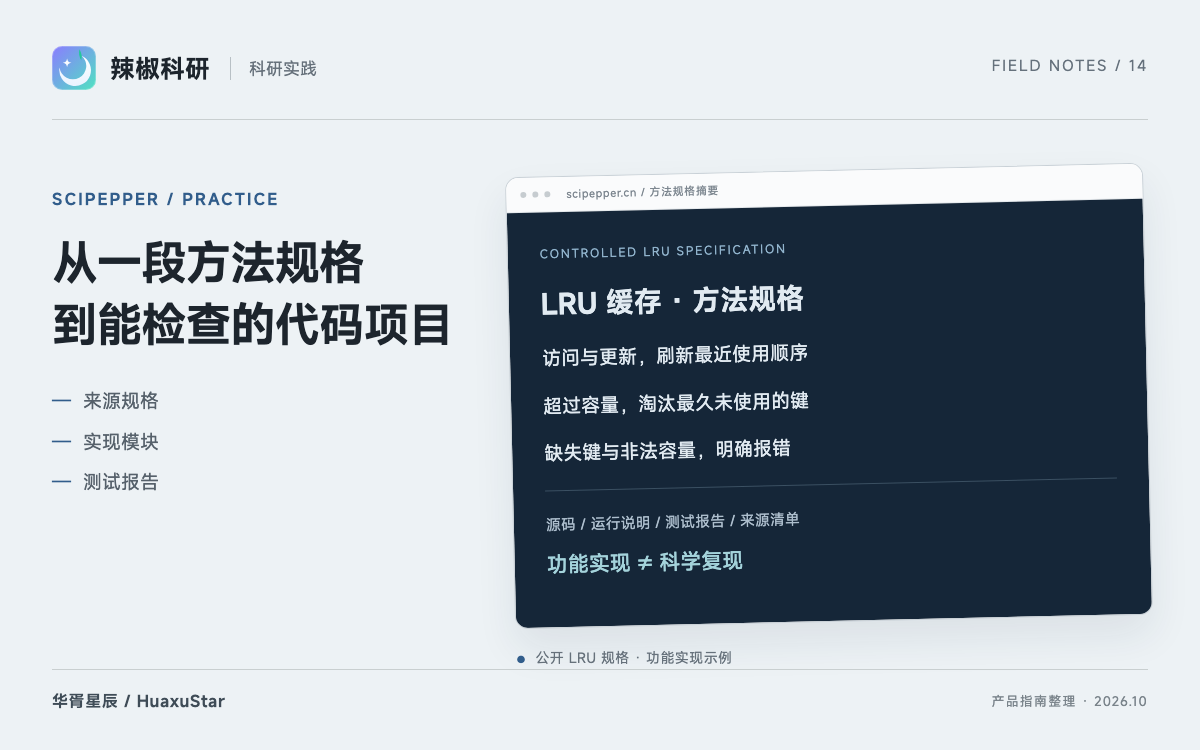
读懂方法以后,下一步常常是实现一个可以检查的最小项目:输入输出是什么、边界条件如何处理、测试覆盖了哪些行为。辣椒科研的项目代码功能将来源、实现计划、源码和测试报告放在同一条转换流程里。
下面以官方公开的 LRU 缓存规格说明用法。它是一份合成方法输入;随指南发布的静态项目是人工编写的功能验证夹具,不能作为模型已经独立复现某项研究的证据。
一、先把实现范围写成规格
在「论文换砖」勾选项目代码,或打开预选代码的工作台。可上传方法文件,也可输入文本并补充要求。
公开 LRU 规格要求:访问或更新键后刷新最近使用顺序,超出容量淘汰最久未使用的键,缺失键与非法容量需要报错。可以先用这份输入文本熟悉审核过程。
实现 Python LRU 缓存、命令行合成示例和 pytest 测试。检查访问与更新后的淘汰顺序、容量为一、缺失键与非法容量。不要补造性能实验或速度提升;README 明确这是功能实现。
这个要求故意不包含吞吐量或模型性能目标,因为源规格没有提供相应实测依据。
二、逐模块审核计划和原文依据
选择实现模块后,检查每个模块的职责、接口、输入输出与精确来源摘录。特别关注缺失的数据、参数和未覆盖能力;原文没定义的部分,应先记录或由你决定,不能悄悄变成「论文就是这样做的」。
当前指南中的生成环境是 Python 3.12 CPU,面向标准库、NumPy 与 pytest 的范围。GPU 训练、数据下载、模型权重和额外依赖,不应假定已经包含在项目交付里。
三、把文件生成与测试结果分开看
确认计划后,产品生成源码并在隔离断网环境中运行测试。下载时检查每份材料,而不是只看到 ZIP 就认为任务成功。
| 交付物 | 要回答的问题 |
|---|---|
| 项目源码与 README | 能从哪个入口运行,哪些能力尚未实现 |
| 来源清单 | 哪段方法支持哪个模块 |
| 测试报告 | 通过、失败、超时,还是未发现测试 |
| 测试日志 | 实际运行了什么,失败发生在哪里 |
| 依赖说明 | 是否在自己的环境中可安装和执行 |
测试失败仍可能有可下载的源码;「文件已生成」与「测试已通过」是不同状态。再次生成也不保证逐字一致,应重新检查。
四、怎样检查公开夹具
可以下载公开项目 ZIP、静态报告和日志,观察目录与交付格式。
这些公开文件展示人工功能验证夹具的结构,不是本篇重新运行的一次模型任务。实际使用时,应读取自己任务的源码、测试和日志,再根据原始规格增加独立用例。
五、从功能检查走向研究复现还缺什么
最小功能实现需要覆盖正常输入、错误输入和状态变化;科学复现还需要真实数据、原论文的评测协议、运行环境、基线和结果对照。两者不应混为一谈。
交付前尝试在自己的受控环境运行项目,并审阅生成代码和测试。测试由模型编写时可能遗漏相同的理解错误,因此通过测试也不等于独立验证。把实现缺口和后续实验条件写进 README,接手者才能准确理解当前成果。
产品入口与资料来源
打开辣椒科研。本文依据以下公开产品指南整理,核对日期为 2026 年 10 月 15 日;具体入口与可用选项以产品当前页面为准。
想在你的业务里试试同样的做法?
告诉我们业务问题与数据现状,我们会给出方案建议与落地路径。
需要帮助?
联系我们的团队,获取贴合你业务场景的方案建议。